
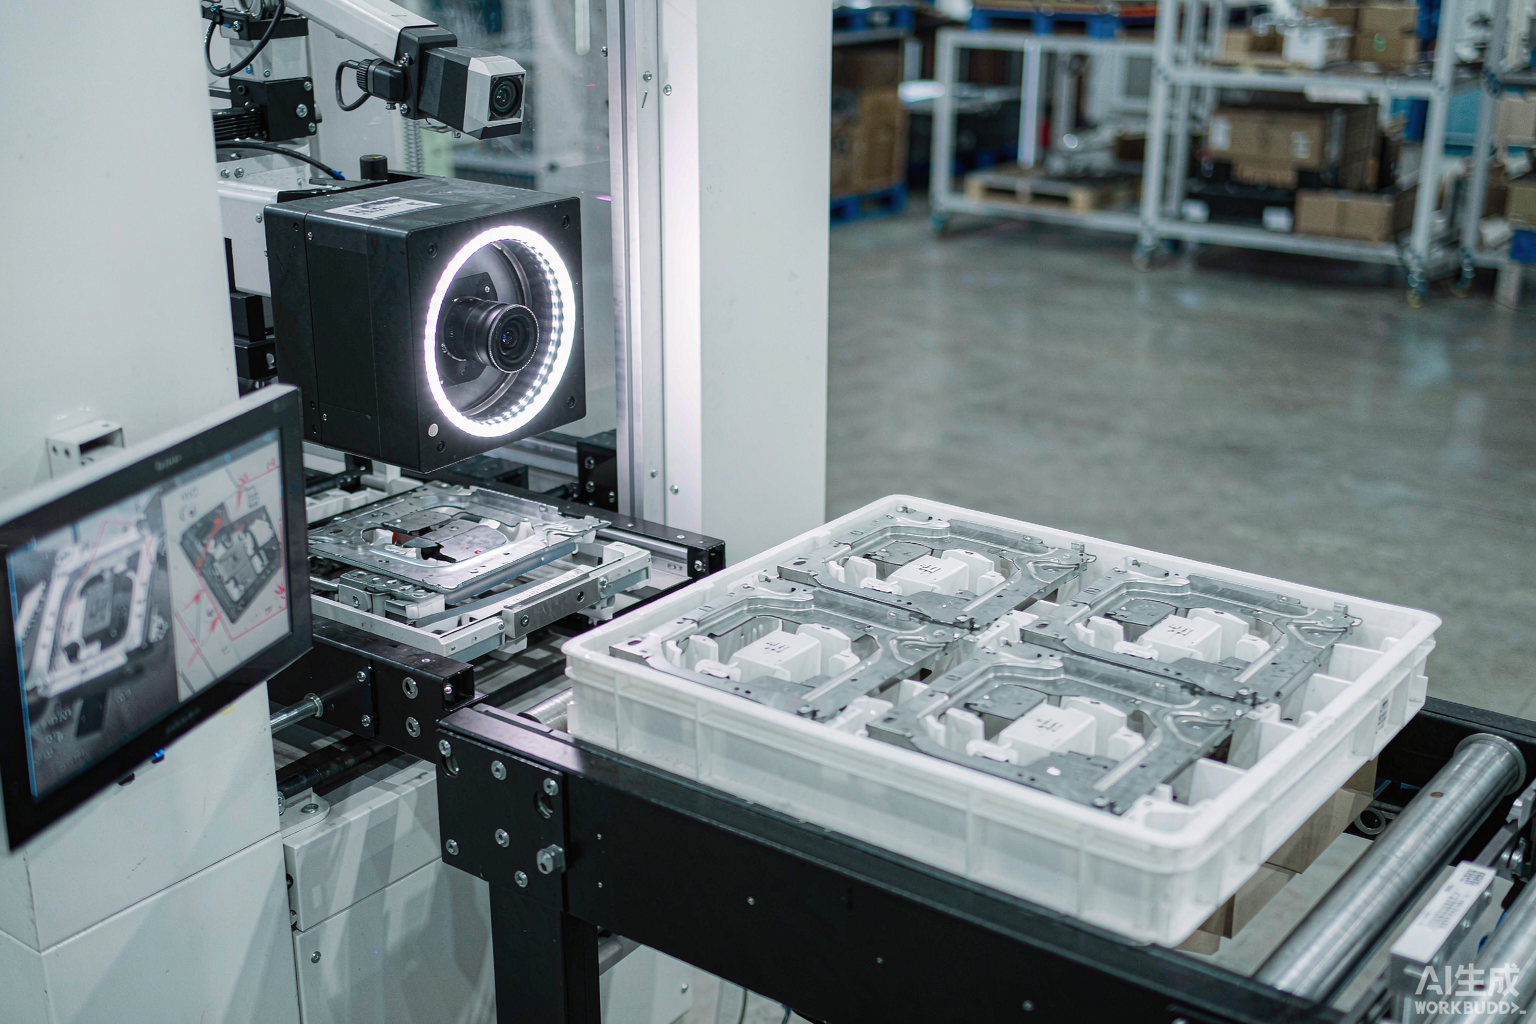
先讲一个真实的失败模式
一家做冲压件的厂,花几十万上了视觉检测,验收时准确率 96%,老板签字。上线三个月后设备停了。为什么?因为96% 是实验室样本上的 96%,产线上光照变了、来料批次换了、夹具松了两毫米,误报一大堆,工人嫌烦直接关掉。
这不是算法不行,是项目从一开始就跑偏了——把“算法准确率”当成了目标,而真正的目标是漏检率可控 + 工人愿意用。
第一件事:先把缺陷定义清楚,而不是先找算法
很多厂说不清自己的缺陷标准。问“什么算不良”,答案是“师傅看了就知道”。这句话就是项目的第一个雷。
落地前必须做的动作:拉上质检主管和产线老师傅,把缺陷分成类、给出可判定的文字描述、每类配 20 张以上真实图。划痕多长算不良、在什么位置算不良、允许的边界在哪。这些写不下来,算法没法学,学出来也没法和人对齐。
这一步枯燥,但它决定了项目 80% 的成败。我们通常建议单独排 2 周做这件事,不要压缩。
第二件事:数据要在真实工况下采,而且要边产边采
第二个常见错误是:拿一批挑出来的“好件和坏件”在灯箱下拍几百张图训练。这种数据训出来的模型,上产线必然崩。
正确做法是在产线实际位置装相机,按真实节拍连续采集 2–4 周,覆盖早中晚不同光照、不同班次、不同来料批次。数据脏一点没关系,脏才是真实。采集期间同步保留人工判定结果,作为标注基准。
还有个现实问题:不良品样本天然稀少。这时候要靠人工复判补标注 + 少量合成样本补短板,但不能指望靠合成数据撑起主力。这一点在 宁波工业垂类大模型落地分析 里也提到过——垂类能力的核心壁垒是真实工况数据,不是模型本身。
第三件事:闭环比准确率重要
第三个坑是没有闭环。检测出不良之后呢?如果没有明确的动作——停机、报警、回溯到具体工位和班次、沉淀成可查的记录——那这套系统对产线就是个装饰。
完整的闭环应该是:检出 → 报警到人 → 记录(工件ID、时间、工位、缺陷类型、图片)→ 定期复盘TOP缺陷 → 反推工艺改进。最后这一步才是真正省钱的地方:当数据告诉你“80% 的划痕来自第三道搬运”,你改的是物流方式,不是检测算法。
中小企业更划算的渐进路径
如果预算有限,不建议一上来做全检替代。我们更推荐的三级跳:
- 第一级:辅助复检。AI 先判,人只复核 AI 判为不良和判不定的那部分。人工作量降一半,风险为零,工人没抵触。
- 第二级:关键项全检。挑 1–2 个后果最严重、特征最明确的缺陷项先做全检,其余仍走人工。
- 第三级:扩展到多品类。前面两级跑顺了、数据攒够了,再谈扩展。
每一级都要能独立产生价值。不要做“全部上线才有意义”的方案,那种项目最容易半途而废。这个思路和 AIGC Lab 五步工作法 一致——先最小实验,有效再放大。
算账的时候,别忘了算漏检的代价
很多老板算 ROI 时只算省了几个质检员,算下来不划算就放弃了。这个算法不完整。真正该算的是:一次批量召回的代价 + 客户索赔 + 订单流失风险。对汽车零部件来说,一次流出批量的代价,往往超过整套系统的投入。
我们在 制造企业AI降本案例 里拆过这个账本结构,可以参考。
最后一句实在话
AI质检能做,但不是所有工序都值得做。判定标准模糊、批量小、换型频繁的产线,投入产出比很差,不如先把工艺和工装做稳。想清楚你的产线属于哪一类,再来决定要不要上。拿不准的,把工序和批量情况发给我们,直接 联系我们,能做的我们说能做,不划算的我们会直说。